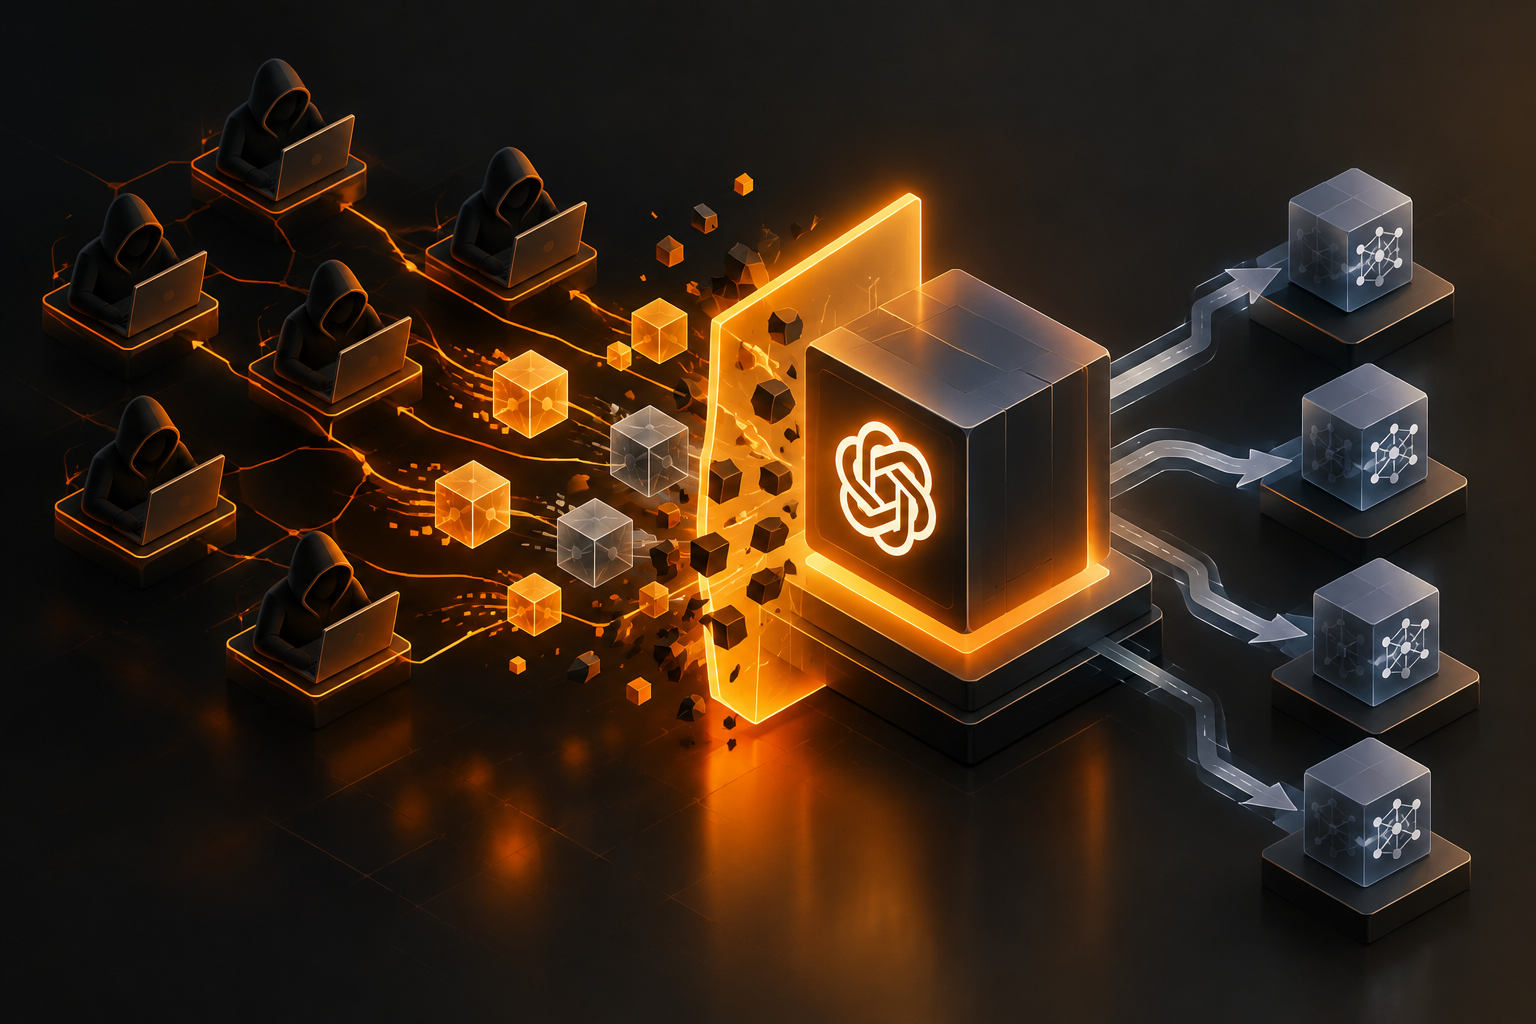
OpenAI hat nach eigenen Angaben eine koordinierte Kampagne zur Extraktion geschützter Modell-Reasoning-Fähigkeiten erfolgreich unterbunden. Das Unternehmen dokumentiert damit erstmals öffentlich einen konkreten Angriff auf seine Systeme durch sogenannte adversarial distillation – eine Technik, bei der Angreifer versuchen, die Fähigkeiten eines geschützten Modells durch systematische Abfragen in ein eigenes, frei verfügbares Modell zu übertragen.
Kurz & knapp
- OpenAI hat einen koordinierten Distillations-Angriff auf seine Modelle gestoppt und öffentlich gemacht
- Die Kampagne zielte darauf ab, geschützte Reasoning-Fähigkeiten zu extrahieren und in andere Modelle zu übertragen
- OpenAI verstärkt daraufhin seine Abwehrmechanismen gegen solche adversarial attacks
- Dies ist eine der ersten dokumentierten Kampagnen dieser Art gegen ein führendes KI-Lab
Was ist Modell-Distillation?
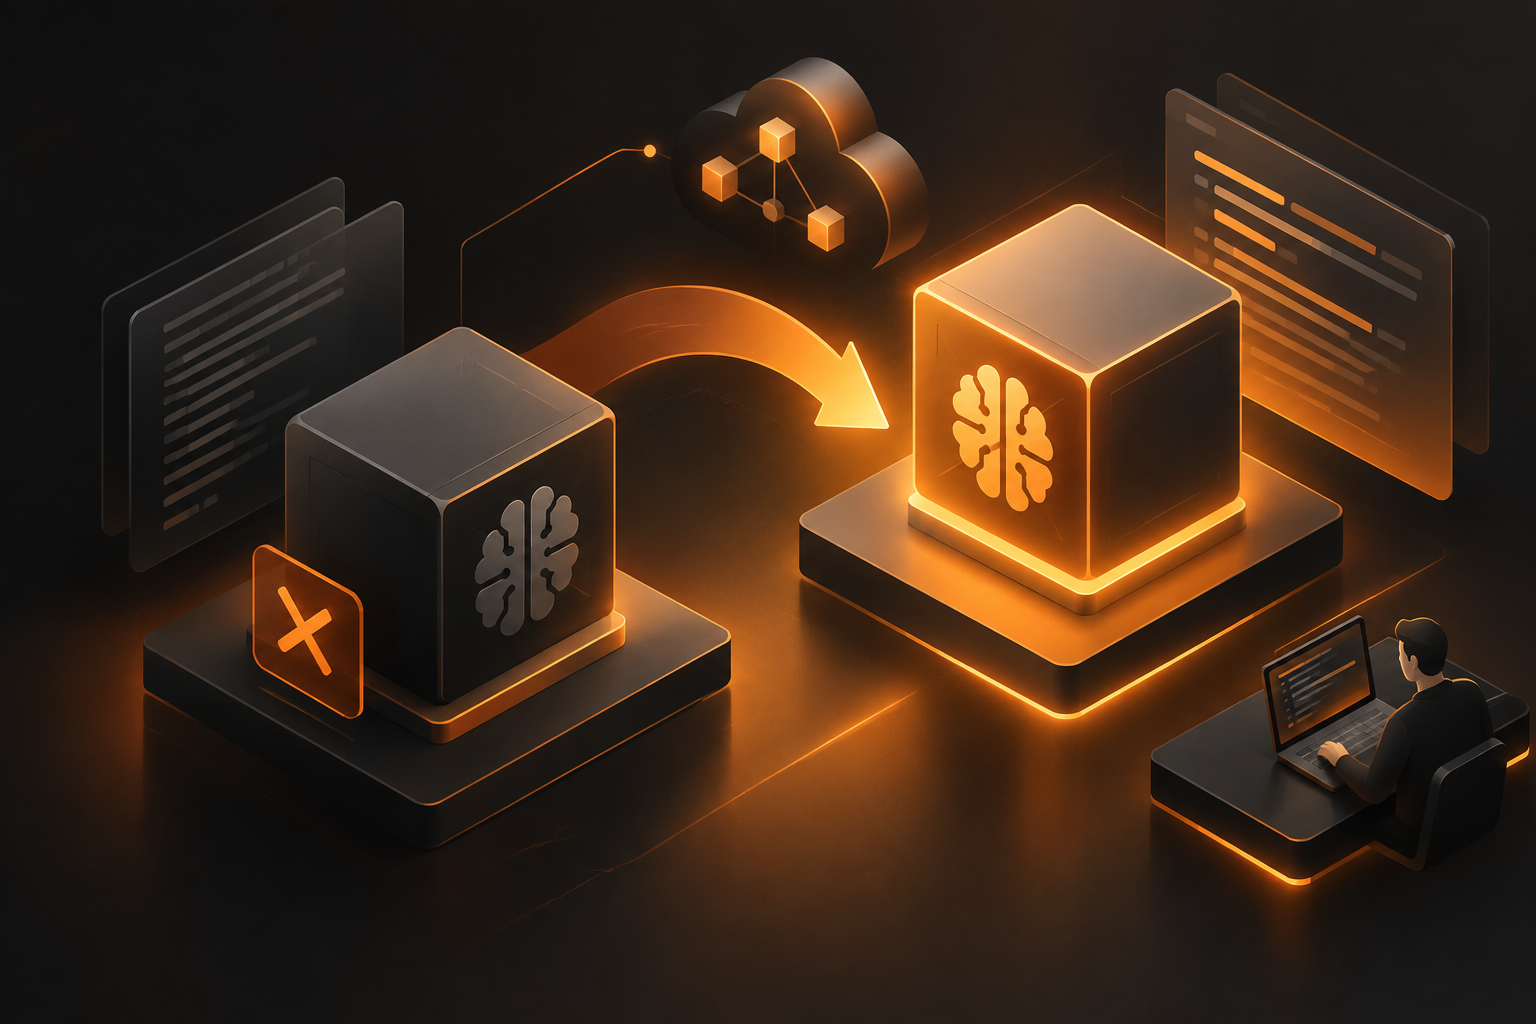
Distillation ist an sich eine legitime Technik: Dabei wird das Wissen eines großen Modells in ein kleineres, effizienteres Modell übertragen. Im Fall von adversarial distillation jedoch nutzen Angreifer diese Methode, um proprietäre Fähigkeiten zu extrahieren. Sie senden systematisch Anfragen an ein geschütztes Modell, erfassen die Antworten und trainieren damit ein eigenes Modell nach – ähnlich wie jemand versuchen könnte, ein Geschäftsgeheimnis durch wiederholte Befragung zu ergründen.
Die Gefahr: Ein Angreifer könnte so teure Trainingsarbeit sparen und gleichzeitig die Sicherheitsmaßnahmen des Original-Modells umgehen.
OpenAIs Gegenmaßnahmen
OpenAI hat die Kampagne nicht nur gestoppt, sondern kündigt auch verstärkte Defenses an. Das Unternehmen gibt allerdings keine Details preis, welche konkreten technischen Maßnahmen es einsetzt – ein üblicher Schritt bei Sicherheitsthemen, um nicht gleichzeitig Angreifern ein Handbuch zu liefern.
Die Veröffentlichung selbst ist ein Signal: OpenAI zeigt damit, dass es Bedrohungen aktiv überwacht und bereit ist, öffentlich über Sicherheitsvorfälle zu kommunizieren. Das kann sowohl Vertrauen schaffen als auch andere Labs dazu bewegen, ähnliche Angriffe zu dokumentieren.
Was das für die Branche bedeutet
Der Vorfall unterstreicht ein wachsendes Dilemma der KI-Industrie: Je leistungsfähiger und wertvoller ein Modell, desto attraktiver wird es für Angreifer. Proprietäre Modelle sind nicht länger nur durch Zugangsschutz gefährdet – auch die Fähigkeiten selbst können gezielt abgezogen werden.
Für deutsche Unternehmen, die KI-Systeme entwickeln oder einsetzen, ergibt sich daraus eine doppelte Aufgabe: Erstens müssen Entwickler damit rechnen, dass ihre Modelle Ziel von Distillations-Angriffen werden können. Zweitens sollten Unternehmen, die fremde Modelle über APIs nutzen, verstehen, dass auch ihre Nutzungsmuster und Anfragen potenziell Teil von Extraktions-Kampagnen sein könnten. Eine Kultur der Sicherheitsaufklärung und der Überwachung ungewöhnlicher Zugriffsmuster wird damit zur Standardanforderung – nicht nur für Labs wie OpenAI, sondern für die gesamte Branche.
Quellen
Redaktionell verantwortet von Ideal Syka. Quellen und Arbeitsweise: Redaktion & Methode. Hinweise und Korrekturen: ai@i6eal.de.