Auf Hugging Face Daily Papers ist ein Preprint mit dem Titel „ACCRUE: Continual Off-Policy Reinforcement Learning for Robot Foundation Models“ (arXiv 2610.18596) erschienen. Die Quelle ist eine Aggregationsseite für Forschungsveröffentlichungen; ob es sich um eine offizielle Stelle handelt, ist aus den vorliegenden Metadaten nicht belegt.
Was das Papier vorschlägt
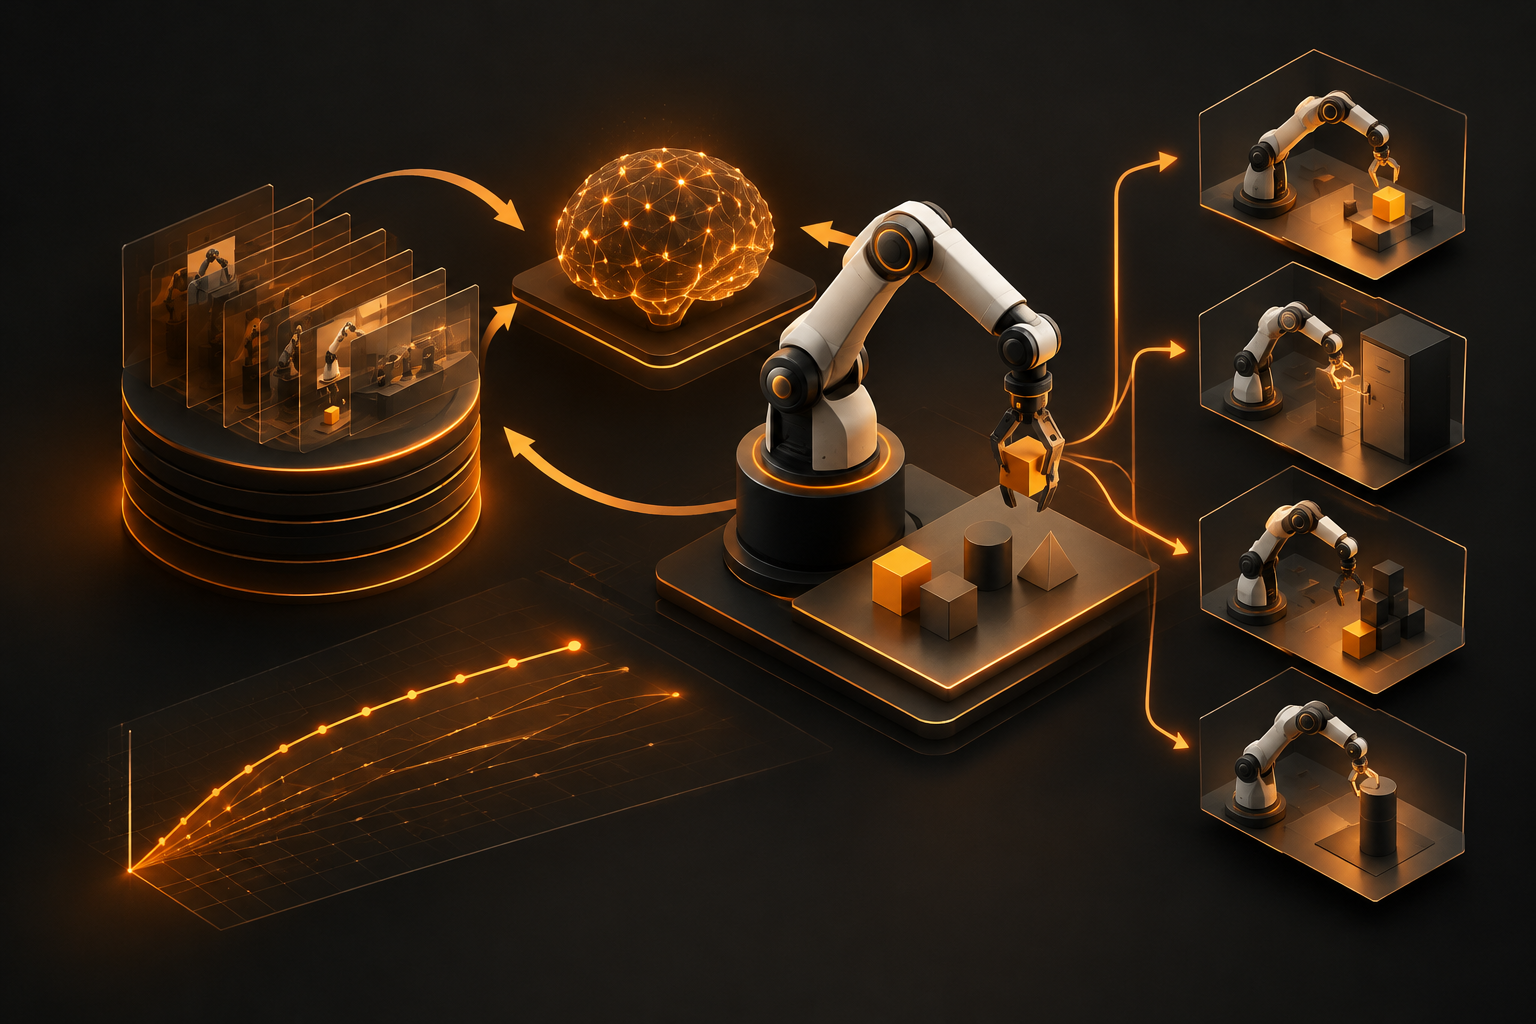
Die Autoren beschreiben ein Reinforcement-Learning-Verfahren für Robot Foundation Models, das leichtgewichtige Actor- und Critic-Netze von einer Aufgabe zur nächsten mitnimmt. Laut Zusammenfassung soll so jede Stufe Verhaltens- und Wertwissen aus früherem RL wiederverwenden. Frühere Verhaltensweisen werden durch Distillation auf zwischengespeicherte Ziele und einige zurückbehaltene Episoden bewahrt.
Angegebene Ergebnisse
Laut Abstract beschleunigt das Verfahren das Lernen nachfolgender Aufgaben bei nahezu null Vergessen, sowohl in Simulation als auch auf realer Roboterhardware bei kontaktreichen Montagesequenzen. Die Trainingszeit am echten Roboter soll sich um 31,0 % bis 68,5 % verringern.
Einordnung
Die Angaben stammen aus dem Abstract eines Preprints und sind nicht unabhängig überprüft. Für deutsche Unternehmen mit Robotik-Montage könnte ein solcher Ansatz künftig relevant werden, falls sich die Ergebnisse außerhalb der Autorengruppe bestätigen. Offen bleibt, wie stabil die Verfahren über viele Aufgaben und Hardwaretypen hinweg sind.
Quellen
Redaktionell verantwortet von Ideal Syka. Quellen und Arbeitsweise: Redaktion & Methode. Hinweise und Korrekturen: ai@i6eal.de.