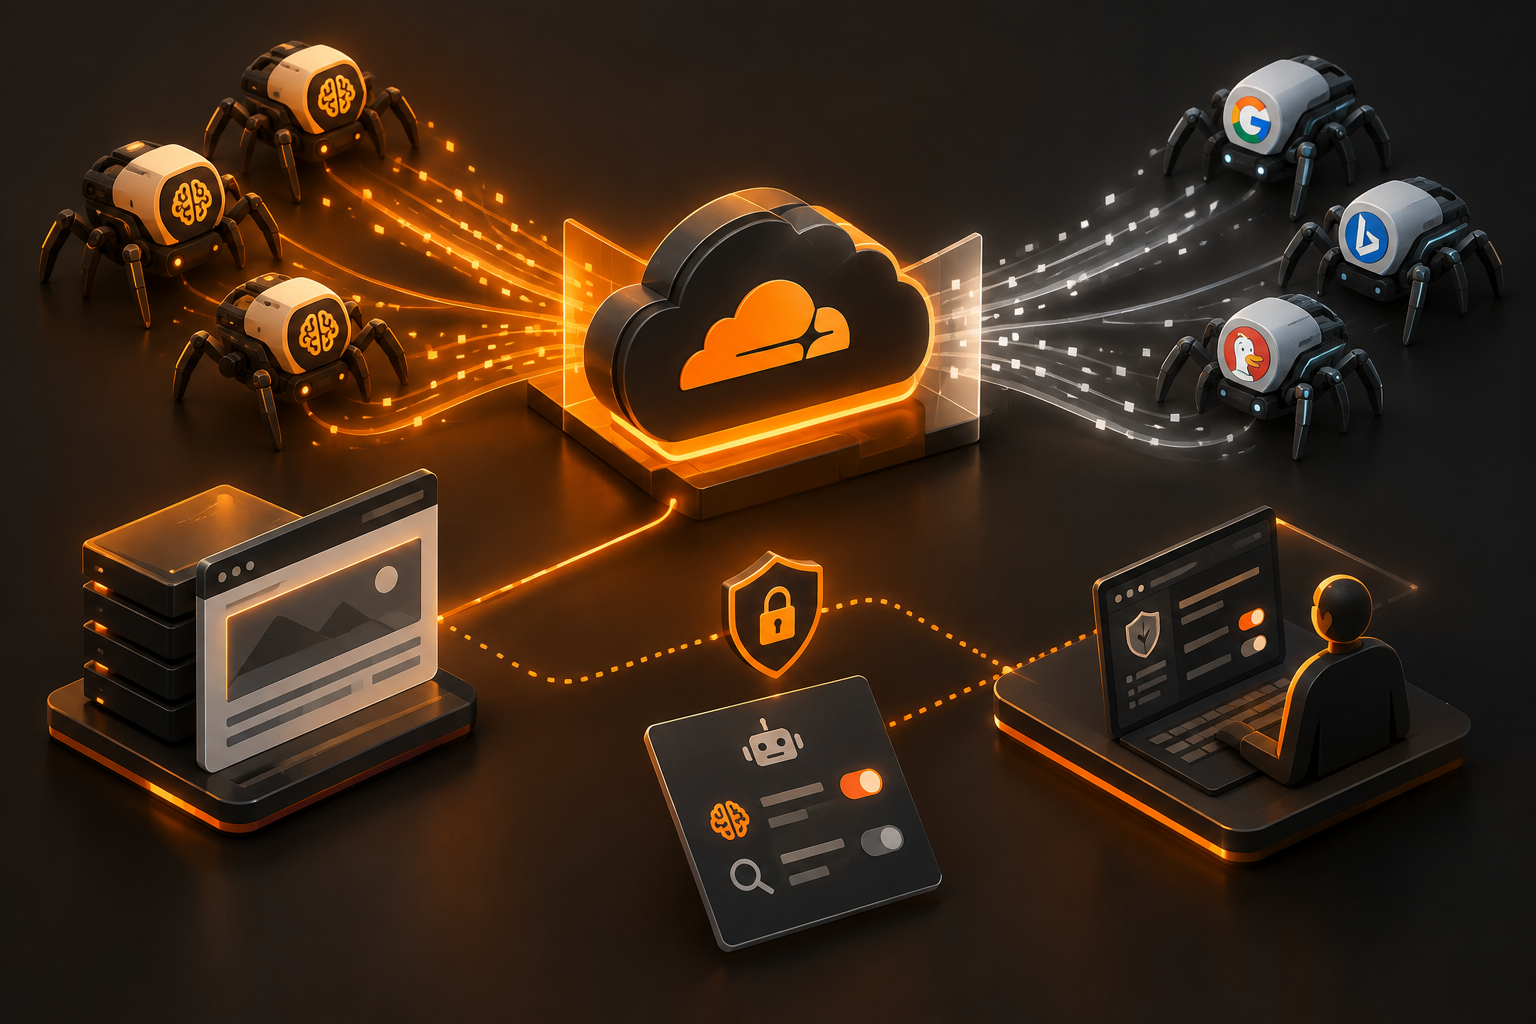
Cloudflare hat ein Feature eingeführt, das Website-Betreibern erstmals eine granulare Kontrolle über verschiedene Arten von Bots gibt. Statt alle Crawler pauschal zu blockieren oder alle durchzulassen, können Betreiber nun KI-Bots separat von Suchmaschinen-Bots behandeln – ein praktischer Kompromiss zwischen Datenschutz und Sichtbarkeit in Google.
Kurz & knapp
- Cloudflare bietet Webseitenbetreibern die Möglichkeit, KI-Crawler zu sperren, ohne Suchbots blockieren zu müssen
- Betreiber können damit ihre Inhalte vor Training von KI-Modellen schützen und gleichzeitig in Suchmaschinen indexiert bleiben
- Das Feature adressiert ein wachsendes Konfliktfeld: Viele Unternehmen wollen ihre Daten nicht für KI-Training freigeben
- Besonders relevant für deutsche Mittelständler, die zwischen SEO-Sichtbarkeit und Datenschutz abwägen müssen
Das Dilemma der Website-Betreiber
Website-Betreiber stehen seit Monaten vor einem Dilemma: Entweder sie sperren alle Bots und verlieren damit ihre Google-Rankings – oder sie lassen alle durch und riskieren, dass ihre Inhalte zum Training von KI-Modellen wie ChatGPT oder Claude verwendet werden. Bislang gab es kaum Mittelwege.
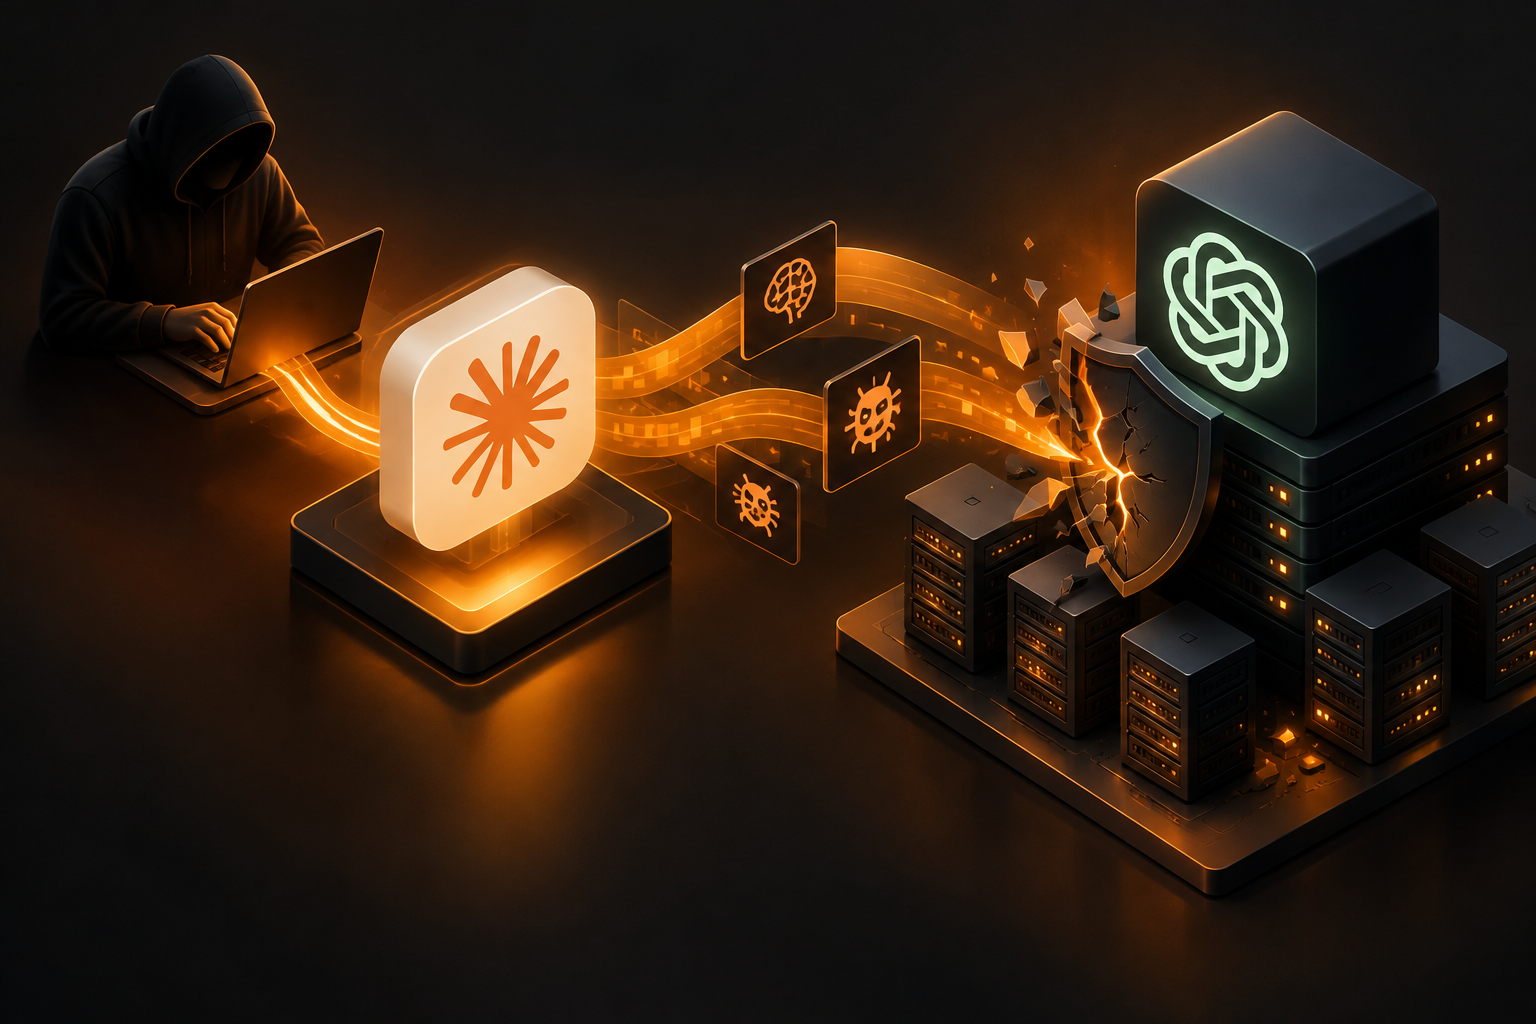
Cloudflares neue Lösung adressiert genau dieses Problem. Mit der Trennung von KI-Crawler-Traffic und Suchmaschinen-Bots können Betreiber nun differenziert entscheiden: Google und Bing dürfen indexieren, aber OpenAI, Anthropic oder andere KI-Anbieter sollen draußen bleiben.
Praktische Umsetzung über robots.txt und User-Agent-Erkennung
Technisch funktioniert das über eine verfeinerte Erkennung von User-Agents und eine intelligentere Interpretation der robots.txt-Datei. Cloudflare identifiziert KI-Crawler anhand ihrer Signaturen und kann sie gezielt blockieren, während legitime Suchbots ungehindert durchkommen.
Das ist wichtig, weil viele KI-Crawler-Betreiber bewusst oder unbewusst ihre Identität verschleiern oder sich als Standard-Browser ausgeben. Cloudflares Infrastruktur-Position ermöglicht es, diese Unterscheidung auf einer Ebene zu treffen, die einzelnen Website-Betreibern sonst verborgen bliebe.
Was das für deutsche Unternehmen bedeutet
Für den deutschen Mittelstand könnte das Feature erhebliche praktische Relevanz haben. Viele Unternehmen – von Fachmedien über Softwarehersteller bis zu Beratungsfirmen – haben berechtigte Gründe, ihre Inhalte vor KI-Training zu schützen: Urheberrecht, Geschäftsgeheimnisse, oder schlicht die Überzeugung, dass ihre Arbeit nicht kostenlos für kommerzielle KI-Modelle genutzt werden sollte.
Gleichzeitig ist SEO-Sichtbarkeit für viele Geschäftsmodelle essentiell. Cloudflares Lösung ermöglicht es, beide Ziele zu verfolgen – zumindest für Kunden, die Cloudflares CDN und Sicherheitsdienste nutzen.
Offen bleibt allerdings, wie vollständig und zuverlässig diese Trennung in der Praxis funktioniert. Auch die Frage, ob alle relevanten KI-Crawler von Cloudflare erkannt werden, lässt sich aus der verfügbaren Information noch nicht beantworten. Zudem ist unklar, ob andere CDN-Anbieter ähnliche Features nachziehen werden.
Quellen
Redaktionell verantwortet von Ideal Syka. Quellen und Arbeitsweise: Redaktion & Methode. Hinweise und Korrekturen: ai@i6eal.de.